This blog is written in Korean.
English translation is available from the language menu in the top navigation bar.
들어가며
일반적인 웹 애플리케이션은 사용자의 요청을 받아 처리한 뒤 결과를 반환합니다. 하지만 모든 작업을 사용자의 요청에 따라 즉시 처리할 필요는 없습니다.
예를 들어 하루 동안 발생한 수백만 건의 거래를 집계하거나, 매일 새벽 정산 데이터를 생성하는 작업은 어떻게 처리해야 할까요?
이처럼 대량의 데이터를 효율적으로 처리하거나 반복적인 작업을 자동화해야 할 때 배치 처리(Batch Processing)를 활용할 수 있습니다.
이번 글에서는 배치 처리의 개념과 웹 처리와의 차이, 실제 동작 방식 및 장애 복구 방법을 알아보겠습니다.
목차
- 배치 처리란?
- Scheduler와 Spring Batch의 차이
- 배치 처리의 작동 과정
- 배치 처리 모니터링
- 배치 처리와 스트림 처리의 차이
- 웹과 배치가 함께 동작하는 시스템
1. 배치 처리(Batch Processing)란?
배치 처리란 미리 정의된 작업을 일정한 시점이나 조건에 따라 사용자와의 지속적인 상호작용 없이 실행하는 데이터 처리 방식입니다.
주로 데이터 백업, 정산, 통계 집계, 보고서 생성 등 대량의 데이터를 처리하거나 반복적인 업무를 자동화하는 데 사용합니다.
웹 처리와 배치 처리의 차이
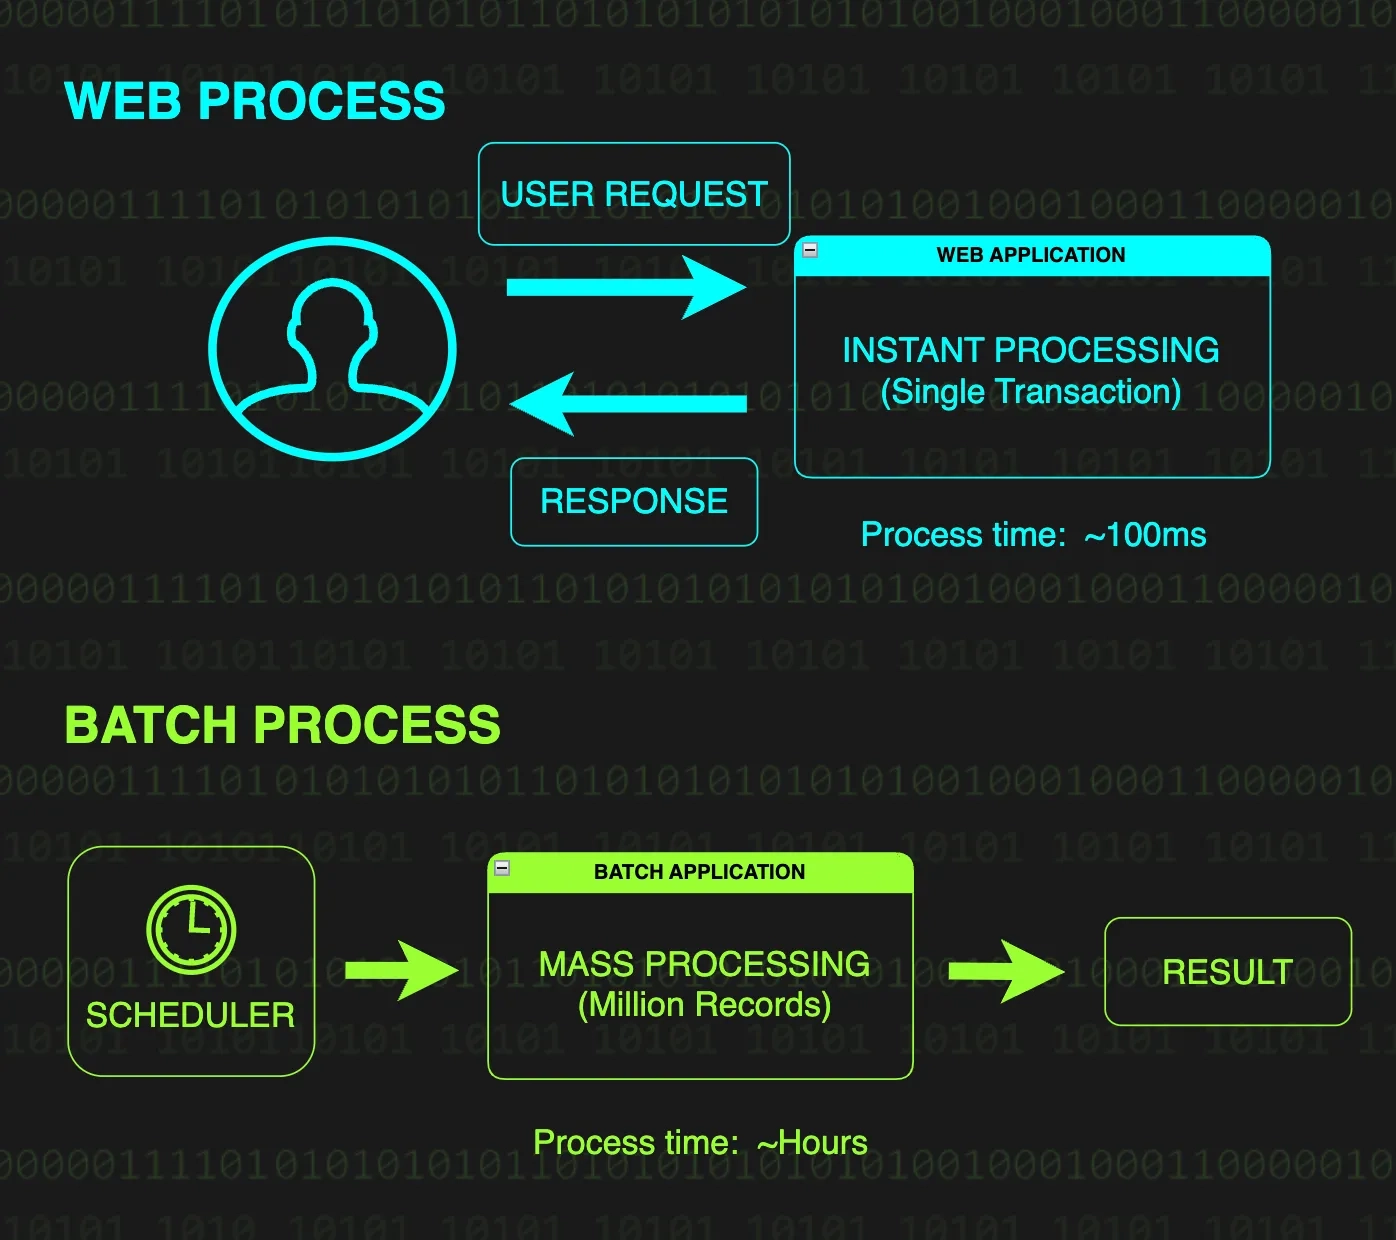
일반적인 웹 애플리케이션은 사용자의 요청이 발생하면 비즈니스 로직을 수행하고 결과를 응답합니다. 반면 배치 시스템은 정해진 시간이나 특정 조건에 따라 작업을 실행할 수 있습니다.
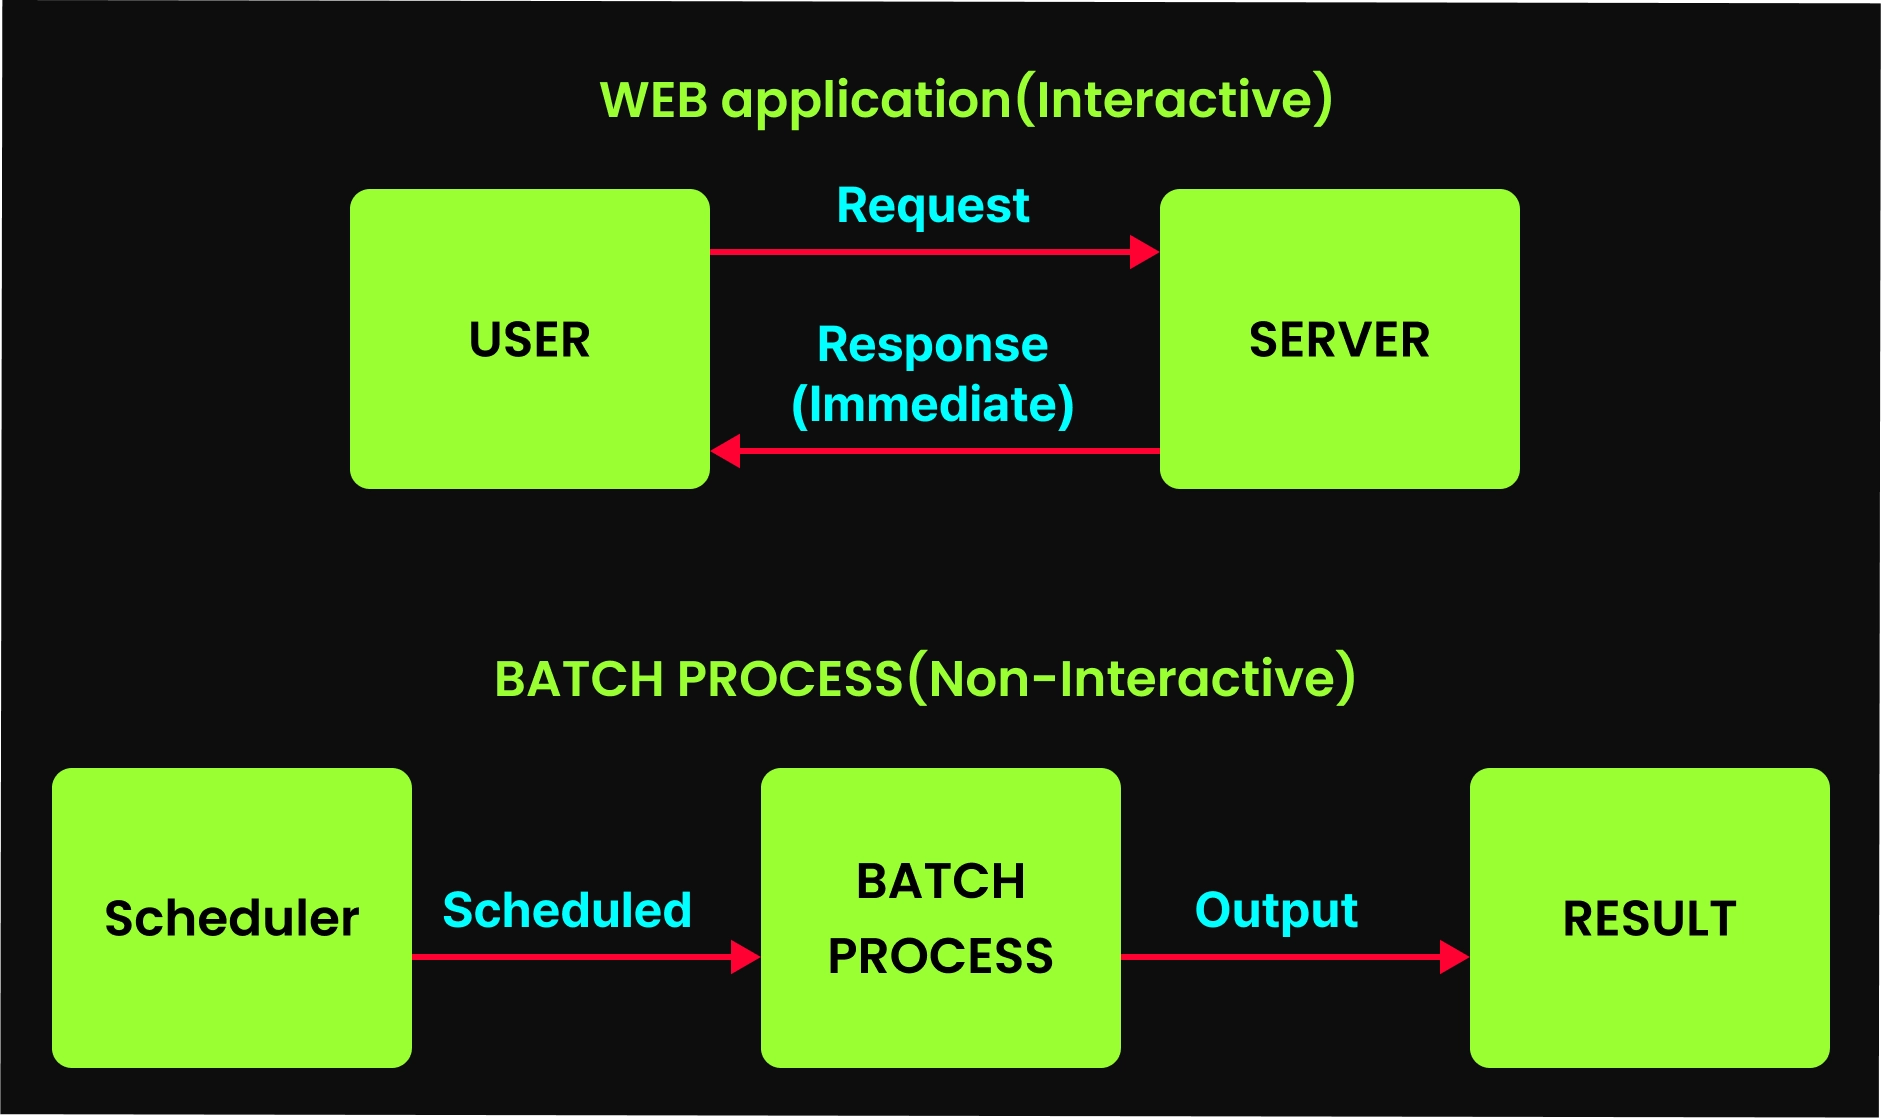
| 구분 | 웹 처리 | 배치 처리 |
|---|---|---|
| 실행 시점 | 사용자 요청 시 | 정해진 시간 또는 조건 |
| 처리 방식 | 요청·응답 중심 | 자동화된 데이터 처리 |
| 주요 목적 | 빠른 응답 제공 | 대량 처리 및 반복 작업 |
| 대표 사례 | 결제 승인, 주문 조회 | 일별 정산, 매출 집계 |
배치 처리는 실행 시점에 따라 정기 실행, 이벤트 기반 실행, 수동 실행 등으로 구성할 수 있습니다.
특히 금융 시스템에서는 실시간 결제 승인과 별도로 거래 집계, 이자 계산, 정산 및 대사(Reconciliation) 등에 배치를 활용합니다.
배치 처리가 중요한 이유
배치 처리는 반복적인 작업을 자동화하고, 대량의 데이터를 일정 단위로 나누어 효율적으로 처리할 수 있다는 장점이 있습니다.
또한 사용자 요청이 적은 시간대에 작업을 예약하면 시스템 부하를 분산할 수 있습니다.
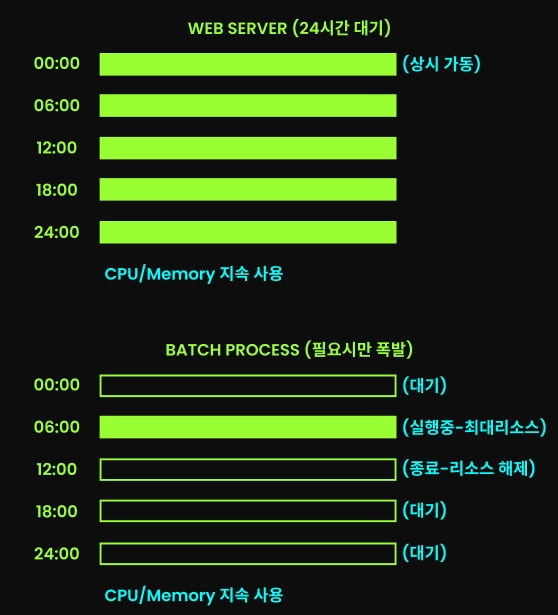
웹 서버는 일반적으로 요청을 처리할 수 있도록 상시 운영되는 반면, 예약형 배치 작업은 특정 시간에 실행되어 리소스를 집중적으로 사용할 수 있습니다.
다만 배치 처리가 반드시 리소스를 절약하는 것은 아니며, 실행 시간과 처리 방식을 적절하게 설계하는 것이 중요합니다.
2. Scheduler와 Spring Batch의 차이
Spring에서는 @Scheduled를 사용하여 특정 작업을 주기적으로 실행할 수 있습니다.
그렇다면 Scheduler와 Spring Batch는 어떤 차이가 있을까요?
Scheduler가 작업을 언제 실행할지 결정한다면, Spring Batch는 실행된 작업의 데이터 처리와 상태 관리를 담당합니다.
예를 들어 100만 명의 사용자에게 쿠폰을 지급하는 작업을 생각해 보겠습니다.
@Scheduled로 실행되는 메서드에서 전체 사용자를 조회하고 단순 반복문으로 쿠폰을 지급한다면 다음과 같은 문제가 발생할 수 있습니다.
- 메모리 부족(OOM): 100만 건을 한 번에 메모리로 조회하면 메모리 사용량이 급격히 증가할 수 있습니다.
- 장애 복구의 어려움: 50만 건을 처리한 후 오류가 발생하면 지급 완료 여부를 확인하고 중복 지급을 방지하는 로직이 필요합니다.
- 실행 상태 관리: 처리 건수와 성공·실패 여부를 추적하려면 별도의 관리 기능이 필요합니다.
Spring Batch는 이러한 요구사항을 처리할 수 있는 기능을 제공합니다.
| 구분 | Scheduler (@Scheduled) |
Spring Batch |
|---|---|---|
| 주요 역할 | 작업 실행 시점 관리 | 데이터 처리 및 실행 상태 관리 |
| 대용량 처리 | 직접 처리 로직 구현 | Chunk 기반 처리 지원 |
| 장애 복구 | 별도 구현 필요 | 재시작 기능 지원 |
| 실행 이력 | 별도 구현 필요 | JobRepository 활용 |
Spring Batch에서는 데이터를 일정한 크기(Chunk)로 나누어 처리할 수 있으며, 실행 상태를 기록하여 실패한 작업을 재시작하도록 구성할 수 있습니다.
단, 재시작 지점은 체크포인트와 트랜잭션 설정에 따라 달라지고, 중복 처리 방지를 위한 설계도 별도로 필요합니다.
Scheduler와 Spring Batch는 대체 관계가 아니라 상호 보완적인 기술입니다. 실제로 @Scheduled로 Spring Batch Job을 실행하도록 구성할 수도 있습니다.
3. 배치 처리의 작동 과정
배치 작업은 일반적으로 다음과 같은 흐름으로 진행됩니다.
작업 실행 → 데이터 읽기 → 데이터 처리 → 결과 저장 → 실행 결과 기록
Java 기반 환경에서는 Spring Batch를 활용하여 이러한 과정을 구현할 수 있습니다.
3-1. Chunk 기반 데이터 처리
Spring Batch의 대표적인 처리 방식은 청크 기반 처리(Chunk-oriented Processing)입니다.
일반적으로 다음 세 가지 구성요소를 사용합니다.
- ItemReader: 데이터베이스나 파일에서 데이터를 읽습니다.
- ItemProcessor: 데이터를 검증하거나 변환합니다.
- ItemWriter: 처리 결과를 저장합니다.
예를 들어 100만 건의 거래 데이터를 1,000건씩 나누어 처리할 수 있습니다.
적절한 Reader를 사용하면 전체 데이터를 한 번에 메모리에 적재하지 않아도 되며, 청크 단위로 트랜잭션을 관리할 수 있습니다.
3-2. 장애 처리 및 복구
배치 시스템에서는 장애가 발생했을 때 어떻게 복구할 것인지가 중요합니다.
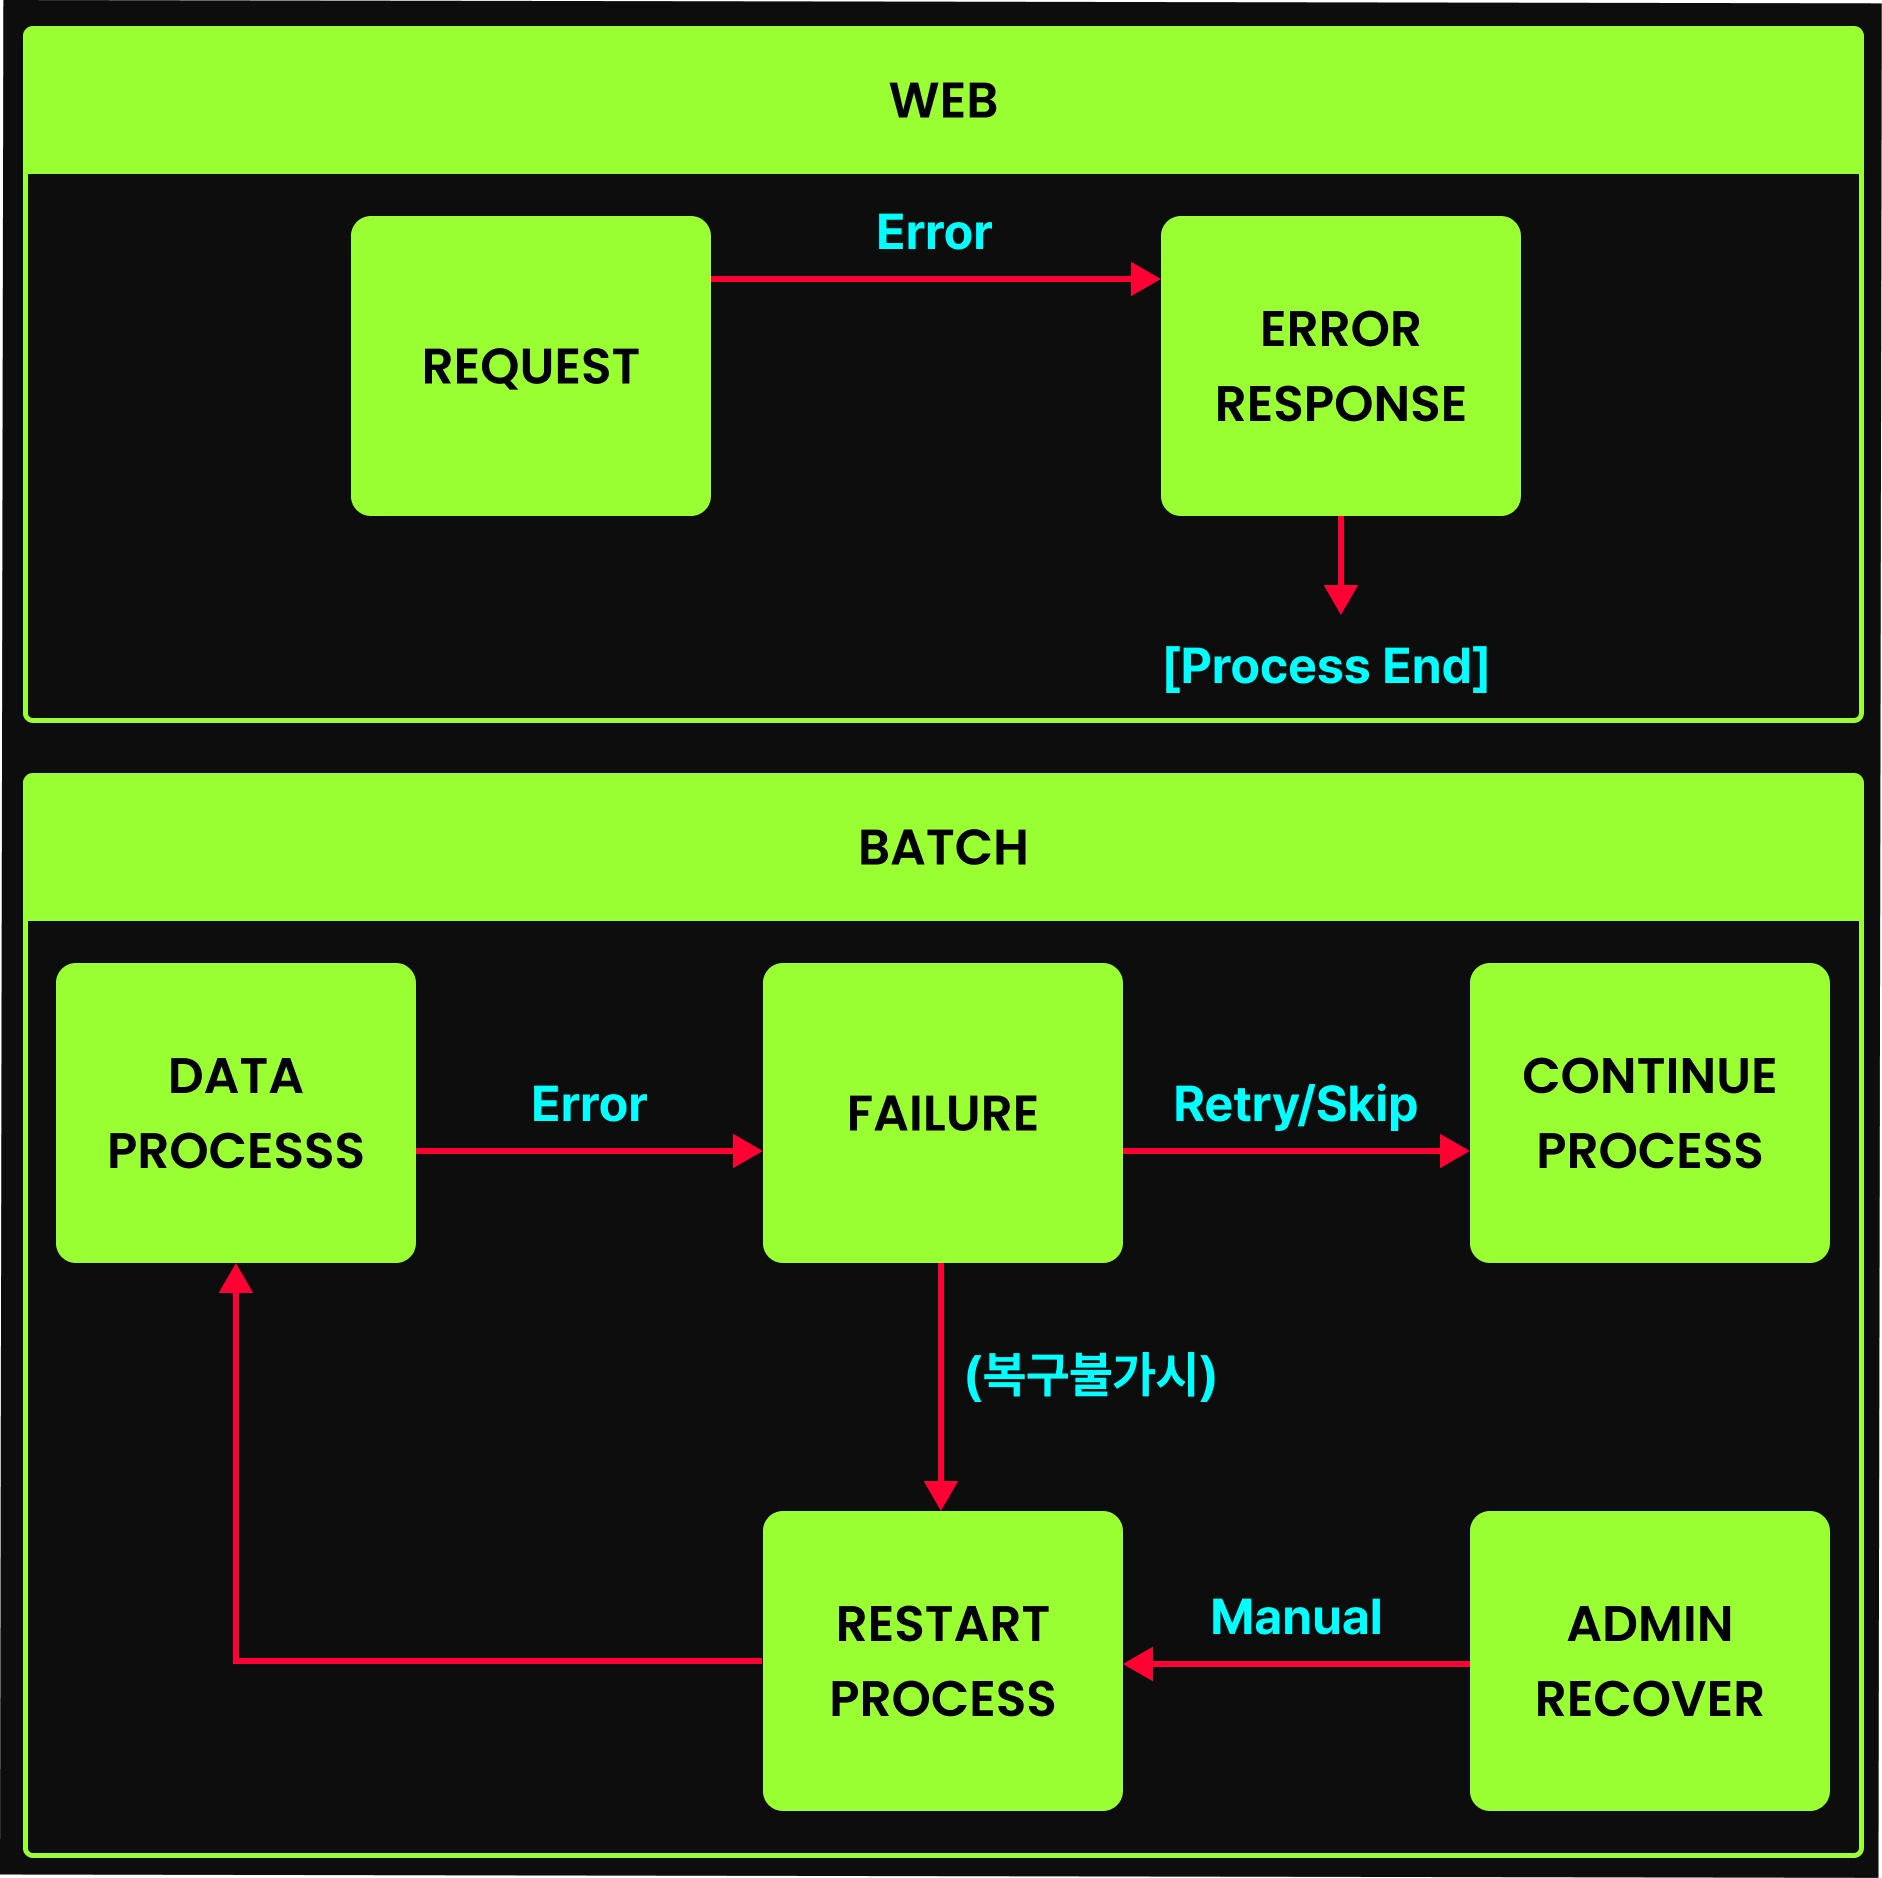
웹 애플리케이션은 요청 처리 중 오류가 발생하면 일반적으로 오류 응답을 반환합니다.
반면 배치 시스템은 장애 특성에 따라 작업을 재시도하거나, 특정 데이터를 건너뛰거나, 실패한 작업을 재시작하도록 설계할 수 있습니다.
대표적인 방식은 다음과 같습니다.
- Retry(재시도): 일시적인 오류가 발생했을 때 정해진 횟수만큼 다시 처리합니다.
- Skip(건너뛰기): 허용 가능한 데이터 오류가 발생하면 해당 항목을 제외하고 처리를 이어갑니다.
- Restart(재시작): 저장된 실행 상태를 기반으로 실패한 작업을 재개합니다.
특히 정산처럼 중복 처리가 허용되지 않는 업무에서는 멱등성(Idempotency)을 함께 고려해야 합니다.
멱등성이란 동일한 작업을 여러 번 실행하더라도 최종 결과가 동일하게 유지되는 성질입니다.
따라서 배치 시스템에서는 단순히 장애를 복구하는 것을 넘어, 재실행 과정에서 데이터의 중복이나 누락이 발생하지 않도록 설계해야 합니다.
4. 배치 처리 모니터링
배치 작업은 자동으로 실행되지만 정상적으로 처리되었는지 확인하기 위한 모니터링이 필요합니다.
대표적으로 다음 항목을 관리합니다.
- 실행 상태: 작업의 시작·종료 시각, 성공 및 실패 여부
- 처리 현황: 읽기·쓰기 건수, 실패 및 건너뛴 데이터 건수
- 오류 추적: 예외 발생 원인, 재시도 및 재시작 이력
- 결과 검증: 원본 데이터와 처리 결과 간의 건수 및 금액 일치 여부
Spring Batch에서는 JobRepository를 통해 작업 실행 상태와 처리 건수 등의 메타데이터를 관리할 수 있습니다.
특히 금융 시스템에서는 배치 작업이 정상 종료되었다는 사실과 실제 데이터가 정확하게 처리되었다는 사실을 구분해야 합니다.
따라서 작업 상태뿐 아니라 처리 결과의 정합성을 함께 검증하는 것이 중요합니다.
5. 배치 처리와 스트림 처리의 차이
배치 처리와 자주 비교되는 방식으로 스트림 처리(Stream Processing)가 있습니다.
두 방식의 핵심적인 차이는 일정 범위의 데이터를 처리하는지, 지속적으로 유입되는 데이터를 처리하는지에 있습니다.
| 구분 | 배치 처리 | 스트림 처리 |
|---|---|---|
| 데이터 처리 | 정해진 범위의 데이터 처리 | 유입되는 데이터의 지속적 처리 |
| 주요 목적 | 집계, 정산, 대량 데이터 변환 | 실시간 분석 및 이벤트 감지 |
| 활용 사례 | 일별 매출 집계 | 실시간 이상 거래 탐지 |
| 대표 기술 | Spring Batch, Spark | Apache Flink, Kafka Streams |
예를 들어 금융 서비스에서 실시간으로 이상 거래를 감지하는 작업에는 스트림 처리를, 하루 동안 발생한 거래를 집계하여 정산하는 작업에는 배치 처리를 활용할 수 있습니다.
두 방식은 서로 대체하는 관계가 아니며, 시스템의 요구사항에 따라 함께 사용할 수 있습니다.
6. 웹과 배치가 함께 동작하는 시스템
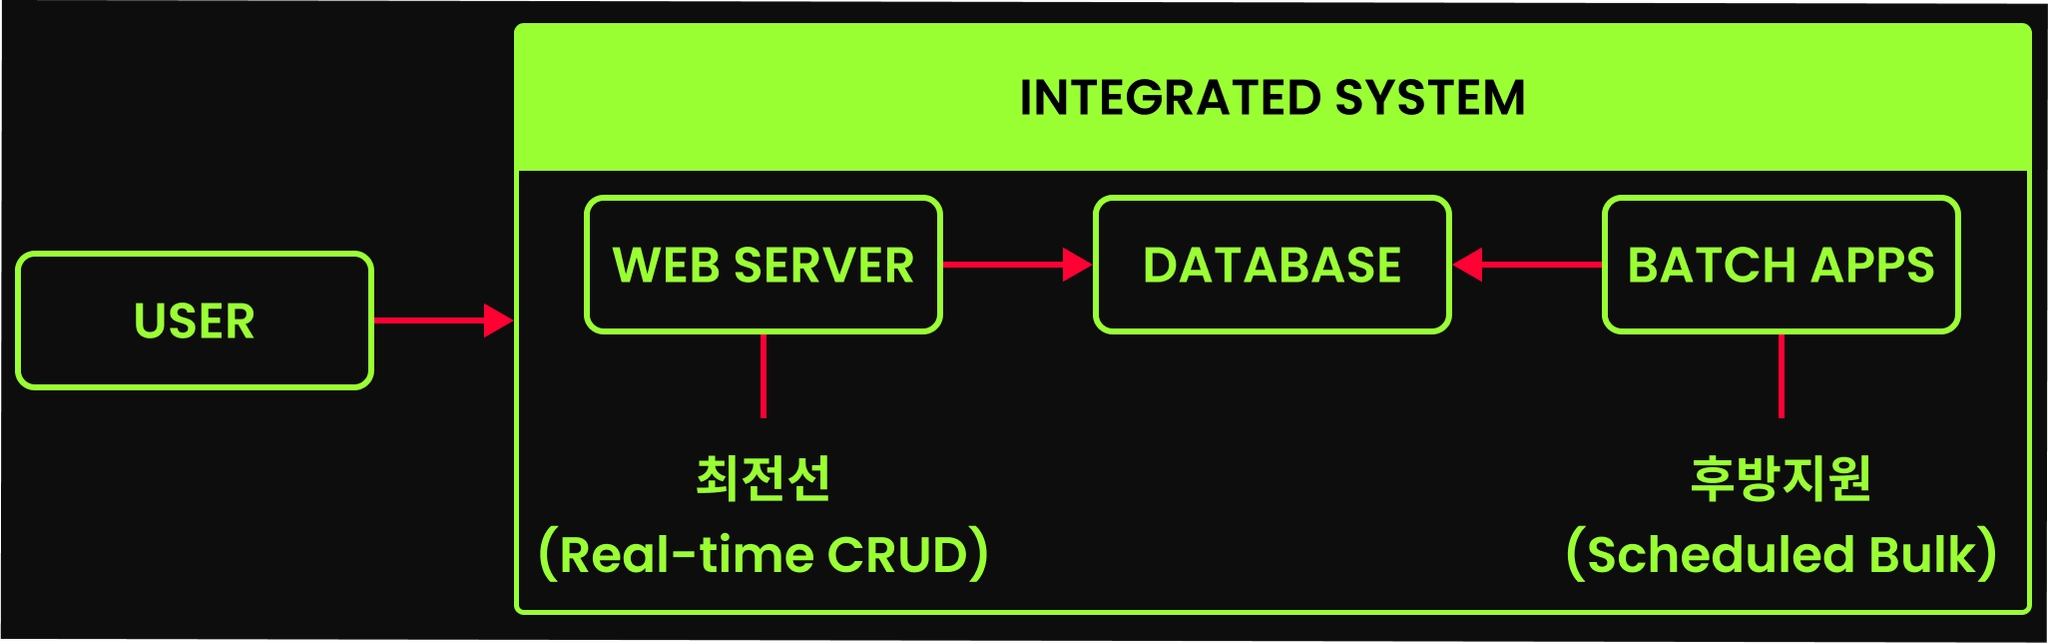
실제 서비스에서는 웹 애플리케이션과 배치 시스템이 하나의 시스템 안에서 서로 다른 역할을 담당하기도 합니다.
예를 들어 금융 시스템에서 사용자가 결제를 요청하면 API 서버는 결제 승인에 필요한 처리를 수행하고, 거래 내역을 데이터베이스에 기록합니다.
이후 배치 시스템은 정해진 시간에 거래 데이터를 조회하여 집계하거나 정산 작업을 수행할 수 있습니다.
즉, 웹 애플리케이션은 사용자 요청을 처리하고, 배치 시스템은 반복적이거나 대량의 데이터 처리가 필요한 작업을 담당합니다.
다만 두 시스템이 동일한 데이터베이스에 접근한다면 잠금 경합이나 성능 저하가 발생할 수 있으므로, 트랜잭션 범위와 작업 실행 시간 등을 함께 고려해야 합니다.
마치며
배치 처리는 대량의 데이터를 효율적으로 처리하고 반복적인 업무를 자동화하기 위한 중요한 처리 방식입니다.
특히 금융 시스템처럼 대규모 거래 데이터를 처리하는 환경에서는 처리 성능뿐 아니라 장애 복구, 중복 처리 방지, 데이터 정합성 및 모니터링이 중요합니다.
결국 안정적인 배치 시스템을 설계하려면 단순히 데이터를 빠르게 처리하는 것보다, 장애가 발생하더라도 데이터를 정확하고 일관되게 처리할 수 있도록 구성하는 것이 중요합니다.
참고
Gemini
ChatGPT
Claude.ai
배치 처리란 무엇인가요?
배치 작업이란 무엇인가요?
배치 처리, 시스템 종결의 서막
배치프로그램이란? (Batch Processing)
누구나 할 수 있는 10배 더 빠른 배치 만들기